Was ein Roboter wirklich sieht: Ein Video ist ein Stapel Zahlengitter
Teil 2 von „Annotation von null an“. Vor jedem Modell, jedem Label, jedem Roboter: Was ist ein Video, wenn man es so betrachtet wie ein Computer? Zahlen, Millionen davon, und keine sagt „Draht“.
- Veröffentlicht
- Autor
- Curatrix
- Reihe
- Annotation von null an, Teil 2 von 16
- Lesezeit
- 4 Min. Lesezeit
Das ist der zweite Beitrag einer Reihe, die wir „Annotation von null an“ nennen. Sie setzt nichts voraus. Wer schon einen Bohrer in der Hand hatte, aber noch nie eine Tabelle geöffnet hat, ist genau die Person, für die wir schreiben. Jeder Beitrag fügt eine Idee hinzu, mit ein oder zwei Zeichnungen, und der nächste baut darauf auf. Am Ende der Reihe wissen Sie, woraus ein Trainingsdatensatz für Roboter besteht, warum Annotation der größte Teil der Arbeit ist und warum die Entscheidung eines Reviewers über eine einzelne Aufnahme zählt.
Wir beginnen vor der Annotation, vor Robotern, vor „KI“. Wir beginnen mit dem, was unsere Mitwirkenden jeden Tag produzieren: einem Video von jemandem bei der Arbeit. Die Frage dieses Beitrags ist einfach. Wenn ein Computer dieses Video betrachtet, was sieht er?
Ein Foto ist ein Gitter aus Zahlen
Eine Kamera nimmt keine Klemmdose und keine Hand auf. Sie nimmt Licht auf. Der Sensor hinter der Linse ist ein Gitter aus winzigen Lichtmessern, und jeder meldet, wie viel rotes, grünes und blaues Licht ihn in einem Sekundenbruchteil getroffen hat. Einer dieser Messer ist ein Pixel. Die Aufnahme in der Abbildung unten ist 1.600 Pixel breit und 820 Pixel hoch, also 1.312.000 Pixel pro Bild (eine Full-HD-Kamera hat 1.920 mal 1.080, die Idee ist dieselbe). Jedes Pixel sind drei Zahlen, eine pro Farbe, jede zwischen 0 (nichts) und 255 (so viel, wie der Sensor messen kann) [1]Szeliski, R. (2022). Computer Vision: Algorithms and Applications (2nd ed.). Springer..
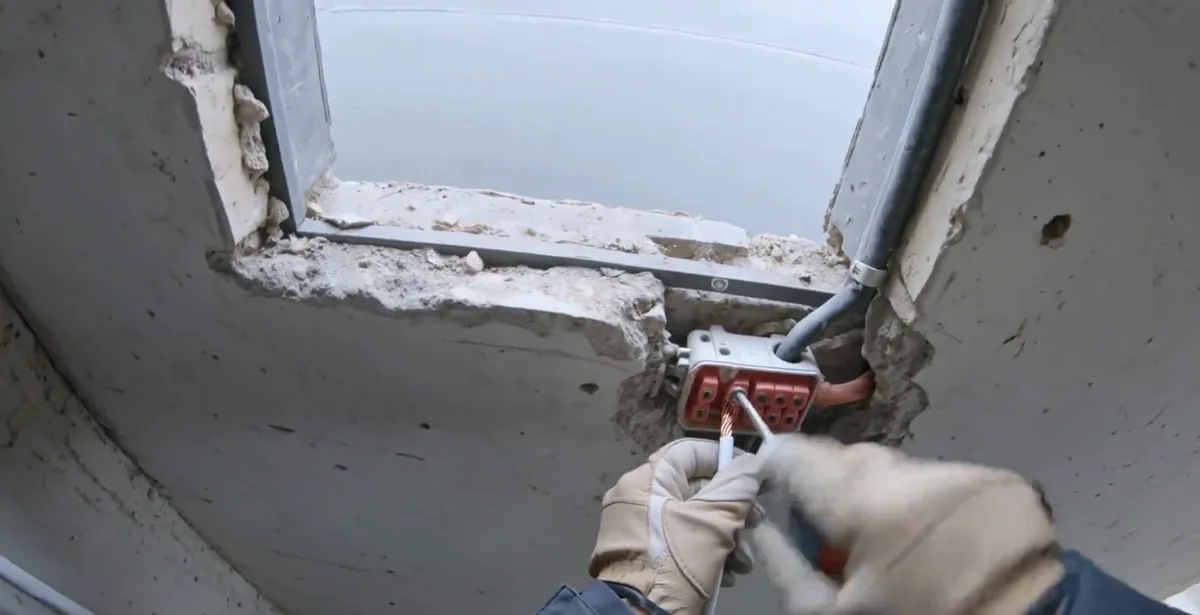
Frame 221 der Aufnahme, 1.600 × 820 Pixel. Das orangefarbene Quadrat markiert die 8 × 8 Pixel, die rechts vergrößert sind.
Pixel in Spalte 1028, Zeile 523
- Rot
- 124
- Grün
- 52
- Blau
- 57
Fahren Sie mit der Maus über die Zellen oder springen Sie mit Tab hindurch. Jede ist drei Zahlen zwischen 0 und 255.
| Rot | 124 | 123 | 121 | 118 | 116 | 125 | 132 | 130 |
|---|---|---|---|---|---|---|---|---|
| Grün | 52 | 50 | 48 | 45 | 44 | 53 | 61 | 62 |
| Blau | 57 | 55 | 52 | 50 | 45 | 52 | 63 | 66 |
1.600 × 820 Pixel × 3 Werte = 3.936.000 Zahlen in diesem Frame.
Dieses einzelne Bild sind also 3.936.000 Zahlen, in einem Gitter angeordnet. Das ist alles. Es gibt keine verborgene Ebene, auf der das Bild „weiß“, dass es eine Klemmdose enthält. Der rote Fleck in der Abbildung ist für den Computer nichts weiter als 64 Zahlentripel, bei denen zufällig die erste Zahl größer ist als die beiden anderen.
Ein Video ist ein Stapel solcher Gitter
Ein Video ist nichts anderes als viele Bilder, die schnell hintereinander gezeigt werden. Diese Kamera nimmt 24-mal pro Sekunde ein neues Gitter auf (andere 25-, 30- oder 60-mal; die Idee ist dieselbe). Jedes Gitter heißt Frame. Eine Sekunde dieser Aufnahme sind also 24 Gitter mit je 3,9 Millionen Zahlen, rund 94 Millionen Zahlen pro Sekunde. Der Zehn-Sekunden-Clip in der Abbildung ist nahezu eine Milliarde Zahlen; eine Minute Handwerk sind rund 5,7 Milliarden.
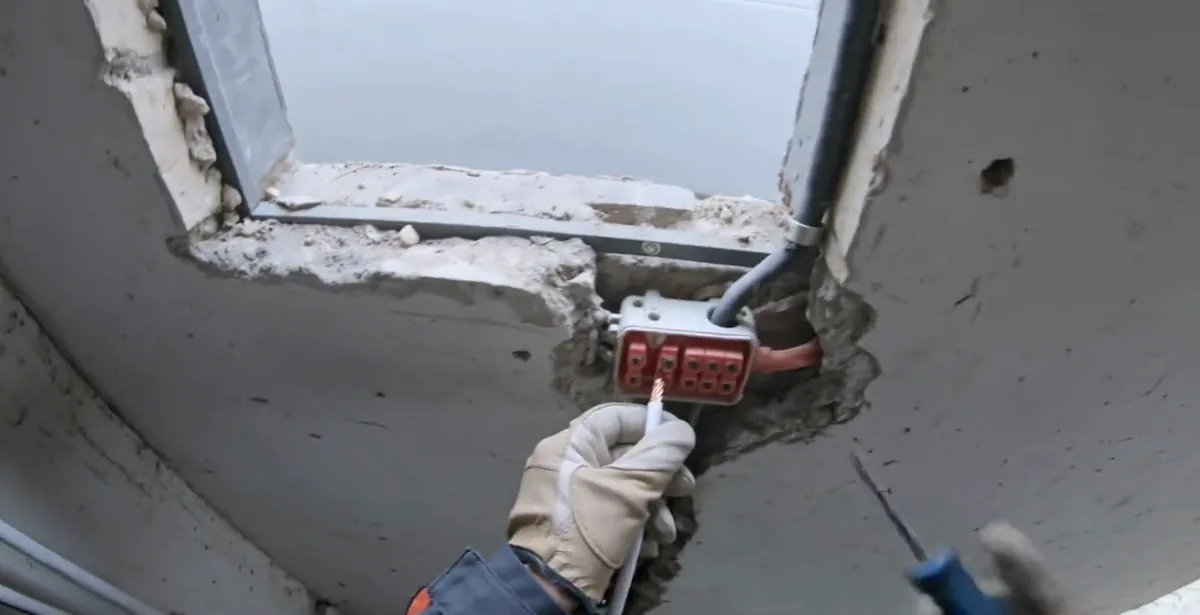
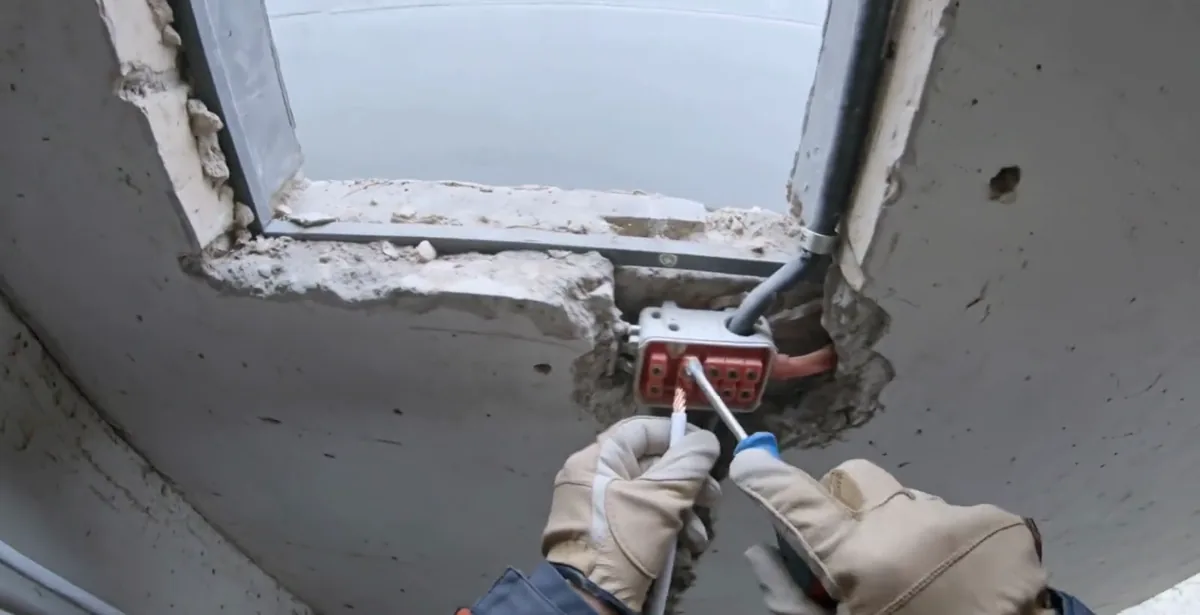
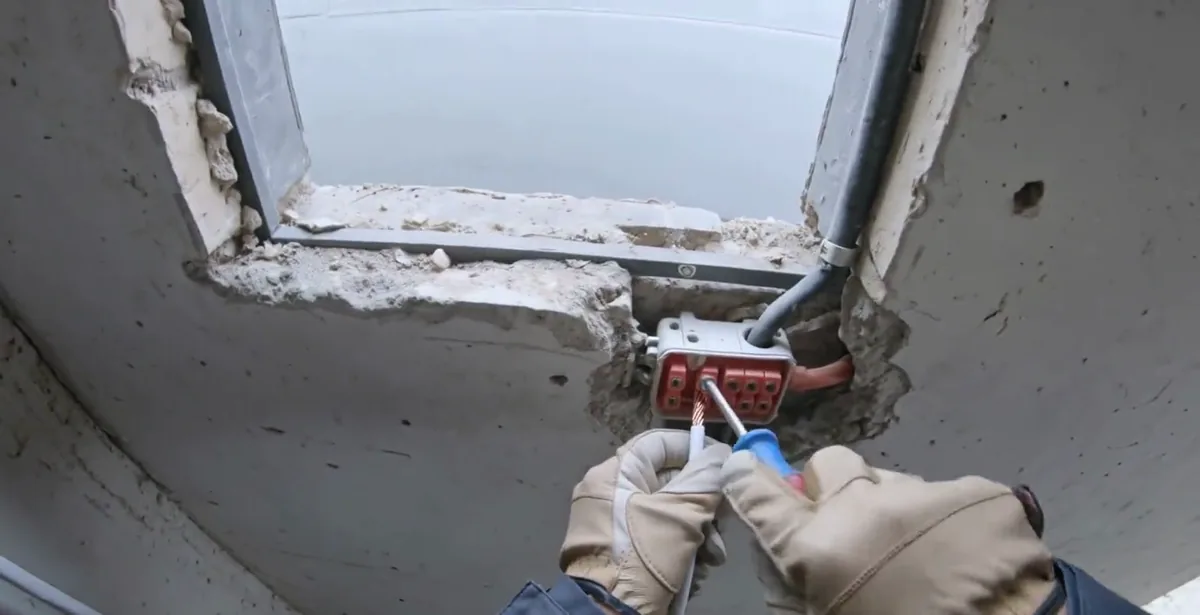
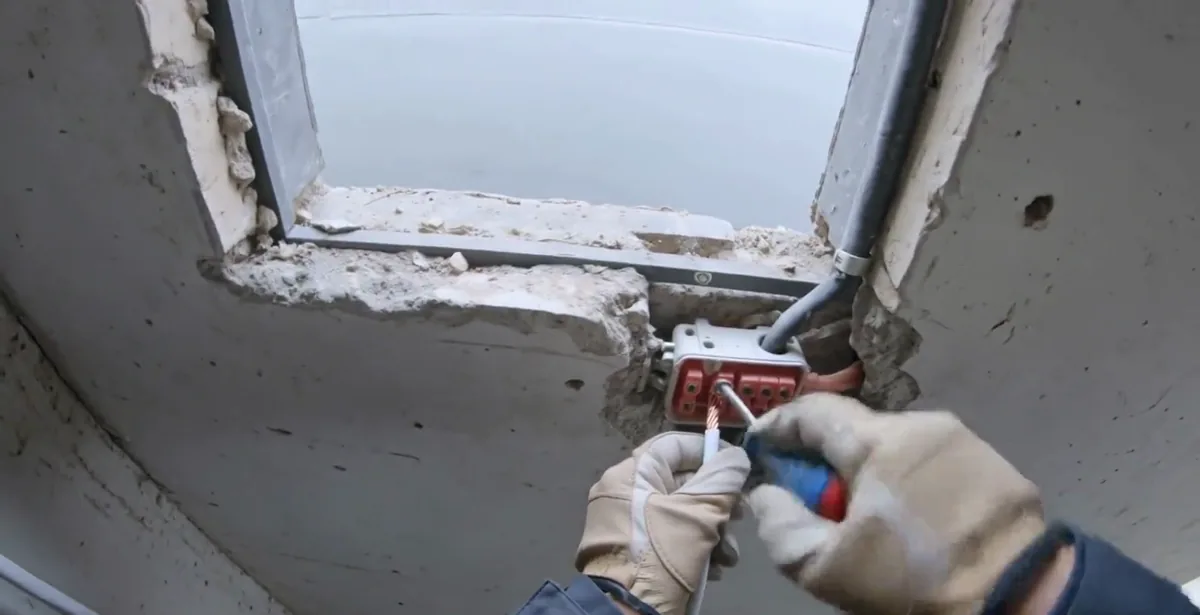
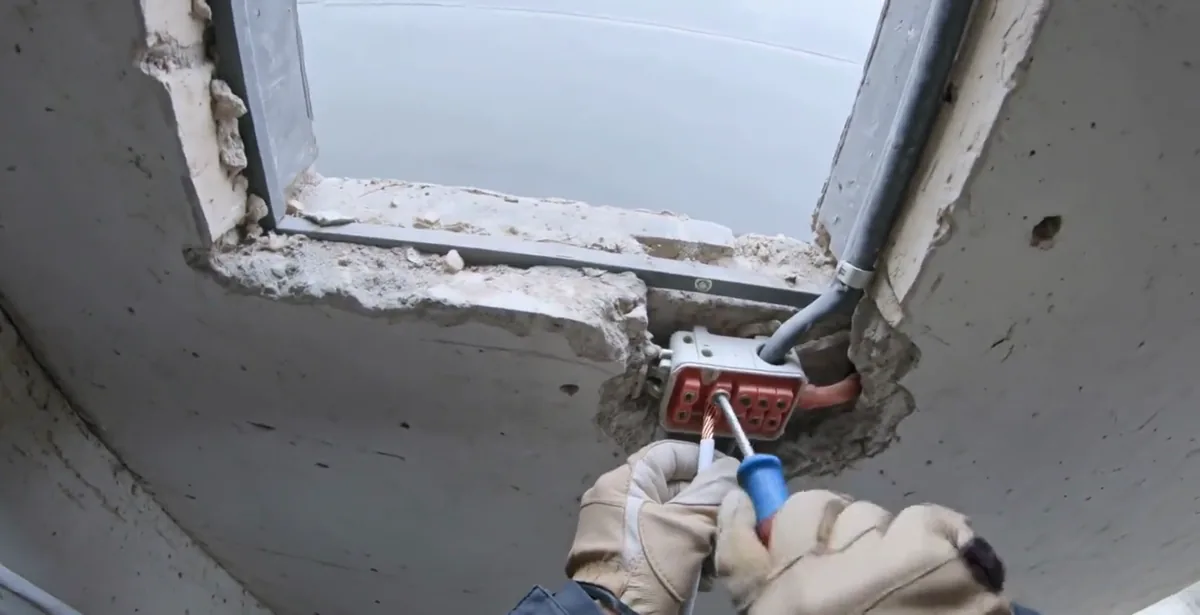
Frame 181 · t = 0,00 s
- Frames pro Sekunde
- 24
- Zahlen pro Frame
- 3.936.000
- Zahlen pro Sekunde
- 94.464.000
- Zahlen in dieser 10-Sekunden-Aufnahme
- 944.640.000
- Keine davon sagt „Klemmdose“, „Draht“ oder „fertig“.
Deshalb sind Videodateien groß, und deshalb werden Videos vor dem Speichern komprimiert. Kompression nutzt geschickt sich wiederholende Muster, ändert aber nicht, was das Video ist: eine lange Liste von Zahlen für Helligkeit und Farbe, geordnet nach Position und Zeit. Egozentrische Datensätze wie Ego4D, aufgenommen mit Kameras am Kopf, bestehen aus genau diesem Rohmaterial, Tausende Stunden davon [2]Grauman, K. et al. (2022). Ego4D: Around the World in 3,000 Hours of Egocentric Video. CVPR 2022..
Warum keine dieser Zahlen einem Roboter bisher hilft
Versetzen Sie sich nun in ein Programm, das aus diesem Video lernen soll, „wie man einen Draht anschließt“. Es bekommt eine Milliarde Zahlen für zehn Sekunden Material. Nirgends in dieser Liste steht das Wort „Draht“, der Moment, in dem der Draht in die Dose ging, oder ob die Arbeit gut lief. Ein Mensch sieht das alles sofort. Das Programm sieht Helligkeitswerte.
Moderne Bildmodelle haben durchaus eine Methode, sich durch diese Zahlen zu arbeiten: Sie zerschneiden jeden Frame in kleine quadratische Flicken, 16 mal 16 Pixel sind eine übliche Wahl, und machen aus jedem Flicken eine kurze Zahlenliste, die ihn zusammenfasst [3]Dosovitskiy, A. et al. (2021). An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale. ICLR 2021.. Die Modelle, die heute die fähigsten Roboter steuern, tun mit ihren Kamerabildern genau das, bevor irgendetwas anderes passiert [4]Black, K. et al. (Physical Intelligence) (2025). π0.5: a Vision-Language-Action Model with Open-World Generalization. arXiv:2504.16054.. Das macht den Zahlenberg kleiner und nützlicher. Das Wort „Draht“ fügt es trotzdem nicht hinzu. Das muss jemand tun.
Dieser Jemand ist eine Annotatorin oder ein Annotator, und was sie hinzufügen, ist ein Label: ein Wort, ein Rahmen, ein Anfangs- und ein Endzeitpunkt, an die Zahlen geheftet. Darum geht es im nächsten Beitrag. Für jetzt reicht eine Idee: Ein Video ist für einen Computer ein Stapel Zahlengitter, und alles, was ein Roboter je aus der Arbeit unserer Mitwirkenden lernen wird, muss ein Mensch oben auf diese Gitter schreiben.
Was das für die Daten bedeutet, die wir liefern
Jede Episode in einem Curatrix-Release beginnt als genau das hier beschriebene Rohmaterial: eine Videodatei pro Kamera, mit konstanter Bildrate und Zeitstempeln. Was daraus eine Trainingsepisode statt eines Heimvideos macht, ist die Schicht darüber: die Grenzen der Teilaufgaben, die Werkzeug- und Objektlabels, das Ergebnis und der Nachweis, wer aufgenommen und wer geprüft hat. Die nächsten Beiträge dieser Reihe erklären jede dieser Schichten, eine nach der anderen.
Wer die längere, technischere Version dieser Geschichte will: Brian Potters Essay über die KI, die Roboter steuert, führt von der Matrizenrechnung bis zu einer aktuellen Roboter-Policy, durchgehend mit handgezeichneten Abbildungen; diese Reihe leiht sich seine Geduld, wenn auch nicht seine Länge [5]Potter, B. (2026). Understanding the AI That Drives Robots. Construction Physics..
Quellen
- 1.
Szeliski, R. (2022). Computer Vision: Algorithms and Applications (2nd ed.). Springer.
Das Standardlehrbuch zur Computer Vision. Kapitel 2 behandelt die Bildentstehung: wie Licht einen Sensor erreicht, wie der Sensor es in ein Pixelgitter abtastet und wie Farbe als Rot-, Grün- und Blauwerte gespeichert wird.
- 2.
Grauman, K. et al. (2022). Ego4D: Around the World in 3,000 Hours of Egocentric Video. CVPR 2022.
3.670 Stunden Video aus der Ich-Perspektive von 931 Kameraträgern in 9 Ländern. Das Paper beschreibt zuerst das Rohmaterial und dann die Erzähl- und Label-Durchgänge, die daraus Benchmarks gemacht haben, derselbe Weg von roh zu gelabelt, dem diese Reihe folgt.
- 3.
Dosovitskiy, A. et al. (2021). An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale. ICLR 2021.
Führt den Vision Transformer ein: Ein Bild wird in Flicken von 16 mal 16 Pixeln zerschnitten, jeder Flicken zu einem Vektor abgeflacht, und die Folge der Flickenvektoren wird wie die Wörter eines Satzes verarbeitet.
- 4.
Black, K. et al. (Physical Intelligence) (2025). π0.5: a Vision-Language-Action Model with Open-World Generalization. arXiv:2504.16054.
Ein Modell zur Robotersteuerung, bei dem Kamerabilder, Textanweisung und Gelenkwerte zu Tokens werden und ein Sprachmodell-Rückgrat sie verarbeitet, bevor ein separater Aktionskopf die nächsten Bewegungen erzeugt. Die offenen Gewichte machen es zu einem konkreten Beispiel dafür, was heutige Roboter-Policies verarbeiten.
- 5.
Potter, B. (2026). Understanding the AI That Drives Robots. Construction Physics.
Ein langer Erklärtext, der von der Matrizenrechnung über neuronale Netze, Attention und Vision Transformer bis zur Roboter-Policy π0.5 führt, mit rund zwanzig handgezeichneten Abbildungen. Das Vorbild für Ton und Tempo dieser Reihe.