Welche Modelle heutige Roboter steuern und was sie mit einem Video tun
Vier Modellklassen stehen zwischen einer Aufnahme und einem bewegten Arm: Detektoren, Segmentierer, Vision-Language-Modelle und Vision-Language-Action-Modelle. Nur das letzte bewegt den Roboter. Was jedes tut, mit den Zahlen aus den Papers.
- Veröffentlicht
- Autor
- Curatrix
- Reihe
- Annotation von null an, Teil 1 von 16
- Lesezeit
- 9 Min. Lesezeit
Fragt man Robotiker, welches Modell ihren Roboter steuert, lautet die ehrliche Antwort: mehrere, und sie tun Verschiedenes. Die meisten Berichte über humanoide Roboter fassen vier verschiedene Modellklassen unter dem Wort „KI“ zusammen. Dieser Beitrag trennt sie. Am Ende können Sie den Modellabschnitt eines Robotik-Papers lesen und sagen, welches Modell sieht, welches labelt, welches Sprache versteht und welches tatsächlich den Arm bewegt.
Wir schreiben aus den Papers, mit den Zahlen, die sie berichten, und kennzeichnen, was eine Unternehmensaussage und kein veröffentlichtes Ergebnis ist. Alles, was ein Roboter aus Video lernt, läuft durch diese vier Klassen, der Rest der Reihe baut darauf auf.
Eine Policy ist eine Funktion von Pixeln und Wörtern zu Motorbefehlen
Das Modell, das den Roboter bewegt, heißt Policy. Ohne die Architektur ist es eine Funktion: Sie nimmt, was die Kameras jetzt sehen, die Anweisung in Worten und die Gelenkwerte des Roboters, und gibt die nächsten Bewegungen zurück. Aktuelle Systeme geben nicht eine Bewegung zurück, sondern ein kurzes Stück davon, bei π0 sind es 50 Schritte [14]Black, K. et al. (Physical Intelligence) (2024). π0: A Vision-Language-Action Flow Model for General Robot Control. arXiv:2410.24164.:
Dabei ist die Kamerabeobachtung zur Zeit , die sprachliche Anweisung, der propriozeptive Zustand (Gelenkwinkel, Greifer), die Länge des Stücks und steht für die Millionen oder Milliarden Zahlen im Modell, die das Training verändert. Der Rest dieses Beitrags handelt davon, woher , und kommen.
Wahrnehmung
Detektor
- Eingabe
- Ein Bild
- Ausgabe
- Rahmen mit Klassenwerten
- Beispiele
- YOLO, Grounding DINO
Labelt Daten. Nie im Regelkreis.
Wahrnehmung
Segmentierer und Tracker
- Eingabe
- Bild oder Video plus Prompt
- Ausgabe
- Pixelmasken, über die Zeit verfolgt
- Beispiele
- SAM, SAM 2
Labelt Daten. Nie im Regelkreis.
Verstehen
Vision-Language-Modell
- Eingabe
- Bild und Text
- Ausgabe
- Text oder ein Vektor
- Beispiele
- CLIP, SigLIP, PaliGemma
Beschreibt Daten; wird zum Rückgrat der Policy.
Steuerung
Vision-Language-Action-Modell
- Eingabe
- Kameras, Anweisung, Gelenkzustand
- Ausgabe
- Motorbefehle
- Beispiele
- RT-2, OpenVLA, π0, GR00T N1
Bewegt den Roboter.
Aus Pixeln werden Tokens
Keine aktuelle Policy liest einen Frame Pixel für Pixel. Der Frame wird verkleinert, in quadratische Flicken zerschnitten, und jeder Flicken wird zu einem Vektor, einem Token. Das ist das Rezept des Vision Transformers [6]Dosovitskiy, A. et al. (2021). An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale. ICLR 2021.: Für einen Frame der Höhe und Breite und Flicken der Seitenlänge gilt
Der Bildencoder in π0 und in PaliGemma ist SigLIP-So400m; er nimmt ein Bild von 224 × 224 Pixeln in Flicken von 14 Pixeln, also Tokens pro Bild [9]Beyer, L. et al. (2024). PaliGemma: A versatile 3B VLM for transfer. arXiv:2407.07726.. Eine Aufnahme von 1.600 × 820 Pixeln wird auf dieses Quadrat gestaucht, bevor irgendetwas anderes passiert. Aus 3,9 Millionen Zahlen werden 256 Vektoren. Diese Kompression ist das Erste, was die Policy mit einem Video tut, und der Grund, warum Bildqualität weniger zählt, als man erwartet, und der Bildausschnitt mehr.
16 × 16 = 256 Tokens
Jede Zelle ist ein Flicken von 14 × 14 Pixeln des verkleinerten Frames, zu einem Vektor gemacht. Das Sprachmodell liest diese 256 Vektoren, wie es 256 Wörter liest.
Eingabe 224 × 224, Flickengröße 14: die SigLIP-So400m-Einstellung von PaliGemma und π0.
Ein Detektor zeichnet Rahmen und sonst nichts
YOLO ist das Modell, von dem die meisten gehört haben, also lohnt es sich, genau zu sein. Das Paper von 2016 teilt das Bild in ein Gitter von Zellen; jede Zelle sagt Rahmen voraus, jeder mit vier Koordinaten und einer Konfidenz, dazu Klassenwahrscheinlichkeiten. Die Ausgabe ist ein Tensor mit Zahlen. Mit , und sind das Zahlen für das ganze Bild [1]Redmon, J., Divvala, S., Girshick, R., Farhadi, A. (2016). You Only Look Once: Unified, Real-Time Object Detection. CVPR 2016..
Die Konfidenz ist definiert als , die Wahrscheinlichkeit, dass ein Rahmen überhaupt etwas enthält, multipliziert damit, wie gut er passen würde. Die Trainingsverlustfunktion ist eine Summe quadrierter Fehler über Koordinaten, Konfidenzen und Klassen, so gewichtet, dass Koordinaten fünfmal so viel zählen wie eine leere Zelle:
Das Original lief mit 45 Frames pro Sekunde bei 63,4 mean Average Precision auf PASCAL VOC [1]Redmon, J., Divvala, S., Girshick, R., Farhadi, A. (2016). You Only Look Once: Unified, Real-Time Object Detection. CVPR 2016.. Die aktuelle Version, YOLO26 vom Januar 2026, berichtet je nach Größe 40,9 bis 57,5 mAP auf COCO und 1,7 bis 11,8 ms pro Bild auf einer T4-GPU [2]Ultralytics (2026). YOLO26 model documentation. Ultralytics Docs.. Zehn Jahre Fortschritt haben die Zahlen geändert, nicht den Vertrag: hinein ein Bild, heraus Rahmen mit Klassenwerten. Kein Gedächtnis, keine Sprache, keine Vorstellung davon, ob eine Aufgabe gelungen ist. Ein Detektor ist ein Wahrnehmungsmodul oder ein Label-Werkzeug. Er steuert den Roboter nicht.
7 × 7 Zellen × 30 = 1.470 Zahlen
Jede Zelle sagt zwei Rahmen (je vier Koordinaten und eine Konfidenz) und zwanzig Klassenwahrscheinlichkeiten voraus. Das ist die gesamte Ausgabe für ein Bild.
S = 7, B = 2, C = 20 wie in Redmon et al. 2016. Spätere Versionen ändern diese Zahlen, nicht die Art der Ausgabe.
Ein Segmentierer macht aus einem Prompt eine Maske und aus einer Maske eine Spur
Ein Rahmen ist grob. Für eine Hand, die einen Draht hält, will man die genauen Pixel. Das Segment Anything Model nimmt einen Prompt, hier einen Punkt, einen Rahmen oder eine grobe Maske, und liefert eine pixelgenaue Maske für das Objekt darunter, in rund 50 Millisekunden im Browser [4]Kirillov, A. et al. (2023). Segment Anything. ICCV 2023.. Trainiert wurde es auf 11 Millionen Bildern und 1,1 Milliarden Masken. SAM 2 fügt ein Gedächtnis über Frames hinzu, sodass ein Prompt auf einem Frame zu einer Maske wird, die durch ein ganzes Video verfolgt wird; sein Trainingssatz enthält 50.900 Videos und 35,5 Millionen Masken, und das Paper berichtet, dass die Annotation mit dem Modell im Kreislauf 8,4-mal schneller lief als ohne [5]Ravi, N. et al. (2024). SAM 2: Segment Anything in Images and Videos. arXiv:2408.00714..
Verkettet mit einem textgesteuerten Detektor wie Grounding DINO wird so heute ein großer Teil des Video-Labelns erledigt: Der Detektor findet „den Draht“ auf einem Frame allein aus dem Wort, der Segmentierer verfolgt ihn durch den Clip [3]Liu, S. et al. (2023). Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection. arXiv:2303.05499.. Beide Modelle wurden einmal von ihren Autoren trainiert und werden wiederverwendet; die Kosten pro Datensatz sind Prompts und Prüfung, nicht Training.
Ein Vision-Language-Modell bringt Bilder und Wörter zusammen
Bevor eine Policy „den braunen Draht anschließen“ befolgen kann, muss etwas das Wort „Draht“ auf eine Pixelregion beziehen. CLIP tat das mit 400 Millionen Bild-Text-Paaren aus dem Web und trainierte einen Bild- und einen Textencoder so, dass zusammengehörige Paare in einem gemeinsamen Vektorraum nahe beieinander landen [7]Radford, A. et al. (2021). Learning Transferable Visual Models From Natural Language Supervision. ICML 2021.. SigLIP behält die Idee und ersetzt die Verlustfunktion. Für einen Batch von Paaren mit normierten Bildvektoren und Textvektoren und für ein echtes Paar, sonst , gilt
Jedes Bild-Text-Paar wird für sich mit einer Sigmoidfunktion beurteilt, eine globale Normierung über den Batch entfällt [8]Zhai, X., Mustafa, B., Kolesnikov, A., Beyer, L. (2023). Sigmoid Loss for Language Image Pre-Training. ICCV 2023.. PaliGemma setzt diesen Encoder vor ein Sprachmodell mit 2 Milliarden Parametern und trainiert das Paar auf einer Milliarde Beispiele; das Ergebnis liest ein Bild und schreibt Text [9]Beyer, L. et al. (2024). PaliGemma: A versatile 3B VLM for transfer. arXiv:2407.07726.. Das ist das Rückgrat, von dem π0 ausgeht.
Ein Vision-Language-Action-Modell setzt auf dieses Rückgrat einen Aktionskopf
Der Schritt von einem Modell, das ein Bild beschreibt, zu einem, das einen Arm bewegt, ist kleiner, als er klingt. RT-1 trainierte 2022 einen Transformer mit 35 Millionen Parametern auf rund 130.000 teleoperierten Episoden von 13 Robotern über 17 Monate und stellte jede Aktionsdimension als eine von 256 Stufen dar [10]Brohan, A. et al. (2022). RT-1: Robotics Transformer for Real-World Control at Scale. arXiv:2212.06817.. RT-2 behielt die Stufen, schrieb sie aber als gewöhnliche Text-Tokens, sodass ein Vision-Language-Modell aus dem Web sie ausgeben konnte [11]Brohan, A. et al. (2023). RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control. arXiv:2307.15818.. Für eine Aktion mit bekanntem Bereich ist die Stufe
OpenVLA skalierte das Rezept auf ein Rückgrat mit 7 Milliarden Parametern und 970.000 Episoden mit offenen Gewichten [13]Kim, M. J. et al. (2024). OpenVLA: An Open-Source Vision-Language-Action Model. arXiv:2406.09246.. π0 änderte, wie Aktionen herauskommen: Statt Tokens erzeugt ein Aktionsexperte mit 300 Millionen Parametern ein Stück von 50 Schritten per Flow Matching, ausgehend von Rauschen und entrauscht hin zur demonstrierten Bewegung. Das Trainingsziel, für ein verrauschtes Stück und Rauschen , lautet
trainiert auf mehr als 10.000 Stunden Roboterdaten von sieben Roboterkonfigurationen [14]Black, K. et al. (Physical Intelligence) (2024). π0: A Vision-Language-Action Flow Model for General Robot Control. arXiv:2410.24164.. π0.5 erweitert es auf neue Wohnungen; rund 400 Stunden Daten eines mobilen Manipulators machen 2,4 Prozent seiner ersten Trainingsphase aus [15]Physical Intelligence (2025). π0.5: a Vision-Language-Action Model with Open-World Generalization. arXiv:2504.16054.. Gemini Robotics lässt ein Gemini-2.0-Rückgrat in der Cloud und einen kleinen Decoder auf dem Roboter laufen, etwa 250 ms von Ende zu Ende [16]Gemini Robotics Team (Google DeepMind) (2025). Gemini Robotics: Bringing AI into the Physical World. arXiv:2503.20020.. GR00T N1 kombiniert ein Vision-Language-Modell mit 2,2 Milliarden Parametern mit einem Diffusions-Transformer, der in 64 ms ein Stück von 16 Aktionen ausgibt [17]NVIDIA (2025). GR00T N1: An Open Foundation Model for Generalist Humanoid Robots. arXiv:2503.14734.. Figures Helix nutzt ein Modell mit 7 Milliarden Parametern bei 7 bis 9 Hz über einem Regler mit 80 Millionen Parametern bei 200 Hz; die Zahlen stammen von einer Unternehmensseite, nicht aus einem Paper [18]Figure AI (2025). Helix: A Vision-Language-Action Model for Generalist Humanoid Control. Company page..
Das Muster bei allen: ein Vision-Language-Rückgrat, trainiert auf dem Web, ein Aktionskopf, trainiert auf Roboterdemonstrationen, und beide zusammen trainiert auf einer großen Mischung, bevor sie auf einem kleinen Satz für einen Roboter feinjustiert werden. Octo und OpenVLA sind offen; π0 und GR00T N1 veröffentlichen Gewichte mit Einschränkungen; Gemini Robotics und Helix sind geschlossen [12]Octo Model Team (2024). Octo: An Open-Source Generalist Robot Policy. RSS 2024..
Roboterdaten sind knapp, menschliches Video nicht
Diese Modelle sind hungrig. DROID, der größte einzelne offene Manipulationsdatensatz, umfasst 76.000 Trajektorien und 350 Stunden, gesammelt von 50 Personen in 564 Szenen über ein Jahr [20]Khazatsky, A. et al. (2024). DROID: A Large-Scale In-The-Wild Robot Manipulation Dataset. RSS 2024.. Open X-Embodiment bündelt 60 Datensätze zu mehr als einer Million Trajektorien über 22 Robotertypen [19]Open X-Embodiment Collaboration (2023). Open X-Embodiment: Robotic Learning Datasets and RT-X Models. arXiv:2310.08864.. Die 10.000 Stunden von π0 sind proprietär. Jede dieser Stunden braucht einen Roboter, eine Bedienperson und eine Szene.
Menschliches Video aus der Ich-Perspektive hat diesen Engpass nicht. Ego4D allein sind 3.670 Stunden von 931 Kameraträgern [21]Grauman, K. et al. (2022). Ego4D: Around the World in 3,000 Hours of Egocentric Video. CVPR 2022.. EgoDex, aufgenommen mit einem Headset mit Handverfolgung, sind 829 Stunden und 338.000 Episoden von Tischaufgaben [22]Hoque, R. et al. (Apple) (2025). EgoDex: Learning Dexterous Manipulation from Large-Scale Egocentric Video. ICLR 2026.. GR00T N1 trainiert auf 2.145 Stunden Ego4D neben 3.289 Stunden echten Roboterdaten und leitet für das menschliche Video Pseudo-Aktionen mit einem gelernten Latent-Action-Modell ab [17]NVIDIA (2025). GR00T N1: An Open Foundation Model for Generalist Humanoid Robots. arXiv:2503.14734.. EgoMimic berichtet, dass menschliche Handdaten die Erfolgsquote gegenüber reinen Roboterdaten um 34 bis 228 Prozent verbesserten und dass eine zusätzliche Stunde menschlicher Daten mehr half als eine zusätzliche Stunde Roboterdaten [23]Kareer, S. et al. (2024). EgoMimic: Scaling Imitation Learning via Egocentric Video. arXiv:2410.24221.. Die Studie von Physical Intelligence von 2025 mischte 3 bis 5 Stunden egozentrisches menschliches Video pro Aufgabe in das Training von π0.5 und fand, dass sich die Leistung in Umgebungen, die nur in den menschlichen Daten vorkamen, nahezu verdoppeln kann, aber erst nach ausreichend vielfältigem Roboter-Vortraining [24]Physical Intelligence (2025). Human-to-robot transfer with egocentric video and π0.5. arXiv:2512.22414..
- DROID350 h76.000 Trajektorien, 564 Szenen, 50 Sammelnde, ein Jahr.
- Helix (Figure)~500 hTeleoperation. Unternehmensseite, kein Paper.
- EgoDex (Apple)829 h338.000 Episoden mit 3D-Handverfolgung aus einem Headset.
- Ego4D, wie in GR00T N1 genutzt2.144,7 hKeine Aktionen; GR00T leitet latente Aktionen mit einem gelernten Modell ab.
- GR00T N1 echte Roboterdaten3.288,8 hTabelle 7 des Papers.
- π0> 10.000 hProprietär; sieben Roboterkonfigurationen, 68 Aufgaben.
Video aus der Ich-Perspektive wird zu Trainingsdaten, wenn es gelabelt und ausgerichtet ist
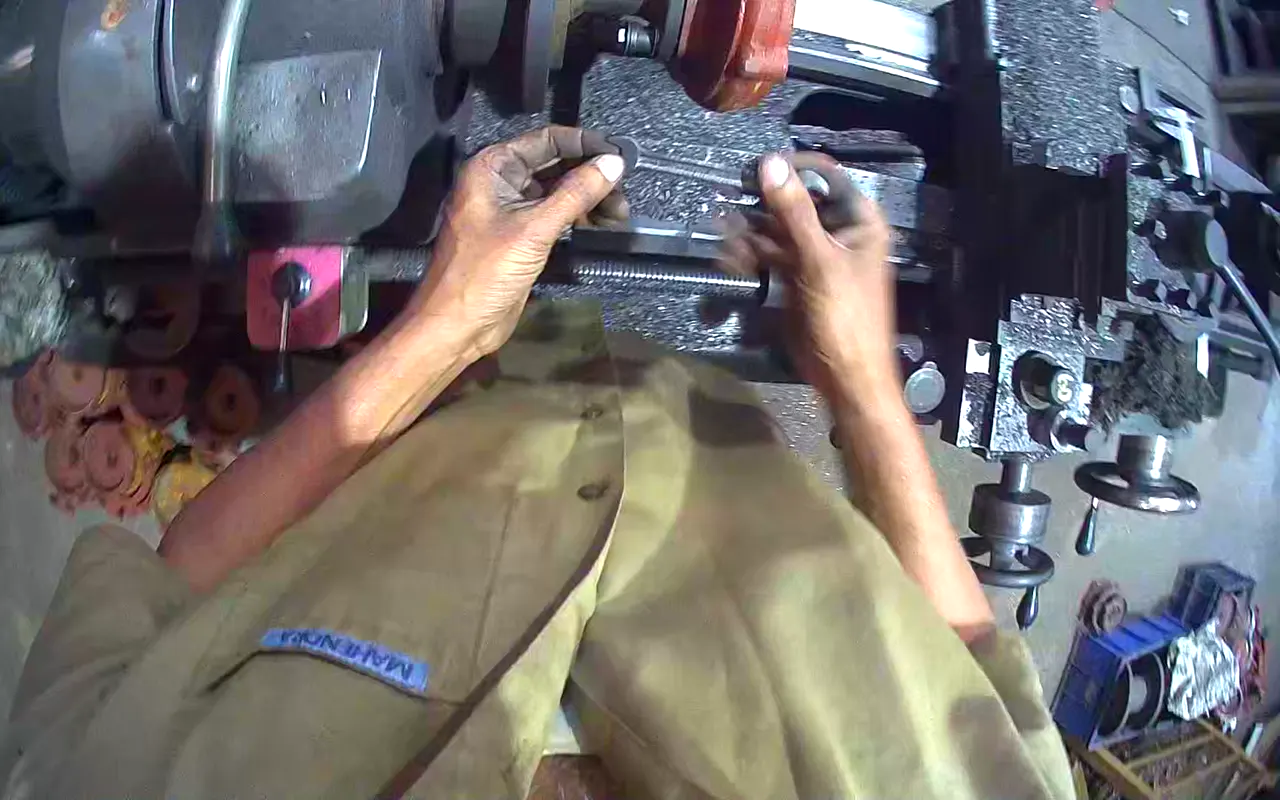
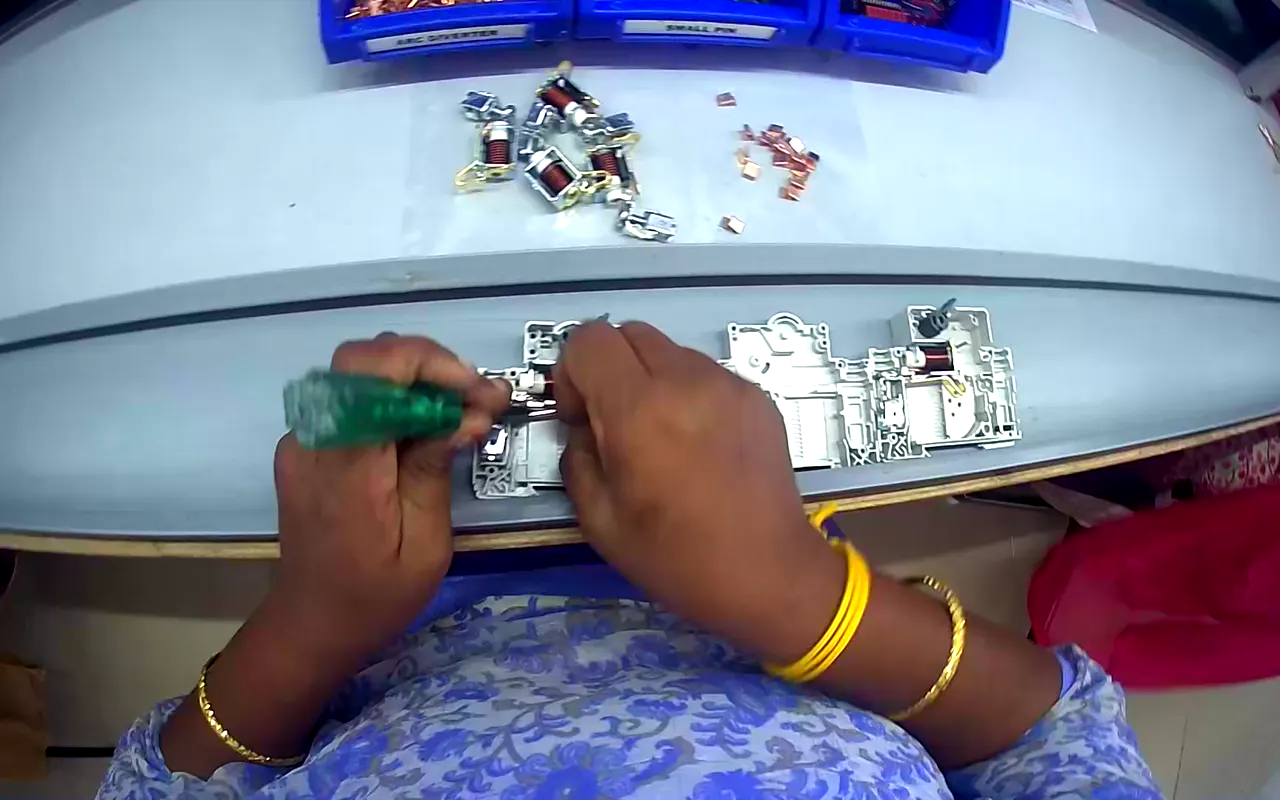
Stellt man die vier Klassen in eine Reihe, schreibt sich die Pipeline von selbst. Rohes Video aus der Ich-Perspektive läuft durch den Label-Stapel: Detektor, Segmentierer und Tracker, ein Handposen-Schätzer, ein beschreibendes Vision-Language-Modell, alle vortrainiert und wiederverwendet. Das Ergebnis wird in Episoden geschnitten: ein Anfang, ein Ende, eine Anweisung und Aktionen, die entweder echte Teleoperationsbefehle sind, auf die Gelenke des Roboters übertragene Handposen oder von einem Modell abgeleitete latente Aktionen. Das Vision-Language-Action-Modell wird einmal auf der großen Mischung vortrainiert und pro Roboter feinjustiert. Nur der letzte Kasten läuft auf der Maschine.
- 01Video aus der Ich-PerspektiveKamera und, wo das Gerät es liefert, Handverfolgung.Pro Datensatz aufgenommen
- 02Label-StapelDetektor, Segmentierer und Tracker, Handposen-Schätzer, beschreibendes VLM.Einmal von den Autoren trainiert, wiederverwendet
- 03EpisodenAnfang, Ende, Anweisung und Aktionen: Teleoperation, übertragene Handposen oder latente Aktionen.Pro Datensatz gebaut
- 04VLA-TrainingVortraining auf der großen Mischung, Feinjustierung auf einem kleinen Satz pro Roboter.Einmal, dann pro Roboter
- 05Policy auf dem RoboterKameras, Anweisung und Gelenkzustand hinein; Aktionsstücke heraus.Läuft auf der Maschine
Was belegt ist, was behauptet wird, was offen ist
Belegt, im Sinne von veröffentlicht mit Zahlen: dass Vision-Language-Rückgrate sich auf Steuerung übertragen lassen (RT-2, OpenVLA, π0), dass Flow Matching glattere Aktionen in hoher Rate erzeugt als Tokens (π0), dass menschliches Handvideo, als weitere Verkörperung mittrainiert, die Erfolgsquote hebt (EgoMimic, Physical Intelligence), und dass Segmentierungsmodelle die Label-Zeit um einen großen Faktor senken (SAM 2).
Behauptet, von Unternehmen ohne Paper: dass Helix Navigation ohne Beispiele aus menschlichem Video gelernt hat. Offen, im Forschungssinn: wie viele Stunden menschliches Video im Allgemeinen eine Stunde Roboterdaten ersetzen, wie man ohne die Handverfolgung eines Headsets verlässliche Aktionen aus Video gewinnt, und ob auf Tischaufgaben trainierte Policies sich auf die langen, vielfältigen Aufgaben eines Handwerks übertragen. Zu diesen Fragen kehrt diese Reihe immer wieder zurück.
Was das für Trainingsdaten bedeutet
Jedes Modell in diesem Beitrag verbraucht dasselbe Rohmaterial: Video mit einer Uhr, in Episoden geschnitten, mit Labels, die ein Modell lesen kann. Detektoren und Segmentierer machen das Labeln handhabbar; die Vision-Language-Action-Modelle bestimmen, was die Labels enthalten müssen: eine Anweisung in Worten, einen Anfang, ein Ende und etwas, das für die Aktion stehen kann. Der nächste Beitrag geht zurück zum ersten Kasten der Pipeline und fragt, was ein Video ist, wenn man es so betrachtet wie diese Modelle.
Quellen
- 1.
Redmon, J., Divvala, S., Girshick, R., Farhadi, A. (2016). You Only Look Once: Unified, Real-Time Object Detection. CVPR 2016.
Formuliert Detektion als eine Regression vom Bild zu einem Tensor S × S × (5B + C); mit S = 7, B = 2, C = 20 hat die Ausgabe 1.470 Zahlen. Berichtet 63,4 mAP bei 45 FPS auf PASCAL VOC und nennt die Grenzen: zwei Rahmen und eine Klasse pro Zelle, kleine gruppierte Objekte.
- 2.
Ultralytics (2026). YOLO26 model documentation. Ultralytics Docs.
Die Version vom Januar 2026. Detektion bei 640 px: 40,9 bis 57,5 mAP 50–95 auf COCO val vom n- bis zum x-Modell, 1,7 bis 11,8 ms auf einer T4 mit TensorRT, 2,4 bis 55,7 Millionen Parameter. AGPL-3.0 mit Unternehmenslizenz.
- 3.
Liu, S. et al. (2023). Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection. arXiv:2303.05499.
Ein Detektor, der eine Textphrase nimmt und die passenden Objekte findet, ohne die Klasse im Training gesehen zu haben: 52,5 AP zero-shot auf COCO. Verkettet mit SAM 2 eine verbreitete Pipeline zum Video-Labeln.
- 4.
Kirillov, A. et al. (2023). Segment Anything. ICCV 2023.
Definiert promptbare Segmentierung: Ein Punkt-, Rahmen- oder Maskenprompt liefert selbst bei Mehrdeutigkeit eine gültige Maske. Trainiert auf SA-1B, 11 Millionen lizenzierten Bildern und 1,1 Milliarden Masken; der Decoder läuft in rund 50 ms im Browser.
- 5.
Ravi, N. et al. (2024). SAM 2: Segment Anything in Images and Videos. arXiv:2408.00714.
Fügt ein Streaming-Gedächtnis hinzu, sodass ein Prompt eine Maske durch ein Video verfolgt. SA-V enthält 50.900 Videos und 35,5 Millionen Masken; die Annotation mit dem Modell im Kreislauf war 8,4-mal schneller und braucht dreimal weniger Interaktionen als frühere Videomethoden. Code Apache 2.0, Daten CC BY 4.0.
- 6.
Dosovitskiy, A. et al. (2021). An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale. ICLR 2021.
Zerschneidet ein Bild in Flicken von P × P, ergibt N = HW / P² Tokens, bettet jeden linear ein und gibt die Folge an einen Standard-Transformer. Überholt Faltungsnetze, sobald auf 14 bis 300 Millionen Bildern vortrainiert.
- 7.
Radford, A. et al. (2021). Learning Transferable Visual Models From Natural Language Supervision. ICML 2021.
Trainiert einen Bild- und einen Textencoder auf 400 Millionen Bild-Text-Paaren aus dem Web mit einer symmetrischen kontrastiven Verlustfunktion, sodass Bild und Text einen Vektorraum teilen. Erreicht auf ImageNet ein überwachtes ResNet-50, ohne ein einziges gelabeltes ImageNet-Beispiel zu sehen.
- 8.
Zhai, X., Mustafa, B., Kolesnikov, A., Beyer, L. (2023). Sigmoid Loss for Language Image Pre-Training. ICCV 2023.
Ersetzt CLIPs Softmax-Kontrastverlust durch einen paarweisen Sigmoidverlust ohne Normierung über den Batch. Erreicht 84,5 Prozent Zero-Shot-Genauigkeit auf ImageNet mit vier TPUv4-Chips in zwei Tagen; der Encoder, den PaliGemma und π0 nutzen.
- 9.
Beyer, L. et al. (2024). PaliGemma: A versatile 3B VLM for transfer. arXiv:2407.07726.
SigLIP-So400m vor Gemma-2B, rund 3 Milliarden Parameter. Bilder mit 224, 448 oder 896 Pixeln werden zu 256, 1.024 oder 4.096 Tokens; Stufe eins trainiert auf einer Milliarde Beispiele. Das Rückgrat, von dem π0 ausgeht.
- 10.
Brohan, A. et al. (2022). RT-1: Robotics Transformer for Real-World Control at Scale. arXiv:2212.06817.
Ein Transformer mit 35 Millionen Parametern über EfficientNet-Merkmalen, trainiert auf rund 130.000 teleoperierten Episoden mit mehr als 700 Aufgaben von 13 Robotern über 17 Monate. Jede Aktionsdimension ist eine von 256 Stufen; die Policy läuft mit 3 Hz.
- 11.
Brohan, A. et al. (2023). RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control. arXiv:2307.15818.
Schreibt die 256 Aktionsstufen als gewöhnliche Text-Tokens, sodass ein auf dem Web trainiertes Vision-Language-Modell (PaLI-X 5B/55B oder PaLM-E 12B) sie ausgeben kann. Das 55B-Modell läuft mit 1 bis 3 Hz, das 5B-Modell mit etwa 5 Hz.
- 12.
Octo Model Team (2024). Octo: An Open-Source Generalist Robot Policy. RSS 2024.
Eine offene Transformer-Policy (27 oder 93 Millionen Parameter) mit Diffusions-Aktionskopf, vortrainiert auf 800.000 Trajektorien aus 25 Open-X-Embodiment-Datensätzen. Nimmt Handgelenk- und Außenkameras, Sprache oder ein Zielbild und Propriozeption.
- 13.
Kim, M. J. et al. (2024). OpenVLA: An Open-Source Vision-Language-Action Model. arXiv:2406.09246.
Eine Policy mit 7 Milliarden Parametern auf Llama 2 mit fusioniertem DINOv2- und SigLIP-Encoder, trainiert auf 970.000 Episoden in 14 Tagen auf 64 A100-GPUs. Ein Bild und Sprache hinein, 256-stufige Aktionstokens heraus bei etwa 6 Hz; Gewichte unter MIT-Lizenz.
- 14.
Black, K. et al. (Physical Intelligence) (2024). π0: A Vision-Language-Action Flow Model for General Robot Control. arXiv:2410.24164.
PaliGemma plus ein Aktionsexperte mit 300 Millionen Parametern, der per Flow Matching Aktionsstücke von 50 Schritten erzeugt, bis zu 50 Hz. Trainiert auf mehr als 10.000 Stunden Roboterdaten von sieben Roboterkonfigurationen; offene Daten sind 9,1 Prozent der Mischung. Gewichte über openpi veröffentlicht.
- 15.
Physical Intelligence (2025). π0.5: a Vision-Language-Action Model with Open-World Generalization. arXiv:2504.16054.
Erweitert π0 auf unbekannte Wohnungen mit einer Mischung, in der rund 400 Stunden Daten eines mobilen Manipulators 2,4 Prozent der ersten Phase sind. Nutzt FAST-Aktionstokens im Vortraining, danach den Flow-Matching-Experten, und sagt vor dem Handeln eine Teilaufgabe in Worten voraus.
- 16.
Gemini Robotics Team (Google DeepMind) (2025). Gemini Robotics: Bringing AI into the Physical World. arXiv:2503.20020.
Ein Gemini-2.0-Rückgrat in der Cloud mit einem kleinen Aktionsdecoder auf dem Roboter: Rückgrat-Latenz unter 160 ms, etwa 250 ms von Ende zu Ende, effektiv 50 Hz Steuerung. Trainiert auf Tausenden Stunden auf ALOHA 2 über zwölf Monate. Geschlossene Gewichte.
- 17.
NVIDIA (2025). GR00T N1: An Open Foundation Model for Generalist Humanoid Robots. arXiv:2503.14734.
Ein Vision-Language-Modell mit 2,2 Milliarden Parametern und ein Flow-Matching-Diffusions-Transformer, der in 64 ms ein Stück von 16 Aktionen ausgibt. Tabelle 7 nennt 3.289 Stunden echte Roboterdaten, 2.145 Stunden Ego4D und weiteres menschliches Video, 1.743 Stunden Simulation; menschliches Video erhält latente Aktionen aus einem VQ-VAE.
- 18.
Figure AI (2025). Helix: A Vision-Language-Action Model for Generalist Humanoid Control. Company page.
Eine Unternehmensmitteilung, kein Paper: ein Vision-Language-Modell mit 7 Milliarden Parametern bei 7 bis 9 Hz über einer visuomotorischen Policy mit 80 Millionen Parametern bei 200 Hz, 35 Freiheitsgrade, trainiert auf rund 500 Stunden Teleoperation mit Sprachlabels aus einem automatischen Label-Modell.
- 19.
Open X-Embodiment Collaboration (2023). Open X-Embodiment: Robotic Learning Datasets and RT-X Models. arXiv:2310.08864.
Bündelt 60 Datensätze von 21 Institutionen zu mehr als einer Million Trajektorien über 22 Roboterverkörperungen und 527 Fähigkeiten in einem Format und zeigt, dass auf dem Pool trainierte Policies die auf Daten eines Roboters trainierten übertreffen.
- 20.
Khazatsky, A. et al. (2024). DROID: A Large-Scale In-The-Wild Robot Manipulation Dataset. RSS 2024.
76.000 Trajektorien und 350 Stunden auf Franka-Panda-Armen, gesammelt von 50 Personen in 564 Szenen in 52 Gebäuden und 13 Institutionen über zwölf Monate, mit 86 Aufgaben. Bei Veröffentlichung der größte einzelne offene Manipulationsdatensatz.
- 21.
Grauman, K. et al. (2022). Ego4D: Around the World in 3,000 Hours of Egocentric Video. CVPR 2022.
3.670 Stunden Video aus der Ich-Perspektive von 931 Kameraträgern an 74 Orten in neun Ländern, erzählt und in Benchmarks für Gedächtnis, Hände und Objekte sowie Vorhersage annotiert. Das größte menschliche egozentrische Korpus im Roboter-Vortraining.
- 22.
Hoque, R. et al. (Apple) (2025). EgoDex: Learning Dexterous Manipulation from Large-Scale Egocentric Video. ICLR 2026.
829 Stunden, 338.000 Episoden und 90 Millionen Frames von Tischaufgaben aus 194 Aufgabentypen, aufgenommen mit Apple Vision Pro bei 30 Hz und 1080p mit 3D-Handverfolgung, sodass jeder Frame Handposen trägt, aus denen eine Policy lernen kann.
- 23.
Kareer, S. et al. (2024). EgoMimic: Scaling Imitation Learning via Egocentric Video. arXiv:2410.24221.
Nimmt menschliche Handdaten mit Project-Aria-Brillen auf und trainiert sie als weitere Verkörperung neben Roboterdaten mit, Hand und Greifer per SAM maskiert. Berichtet 34 bis 228 Prozent Verbesserung gegenüber reinen Roboterdaten und dass eine zusätzliche Stunde menschlicher Daten mehr hilft als eine zusätzliche Stunde Roboterdaten.
- 24.
Physical Intelligence (2025). Human-to-robot transfer with egocentric video and π0.5. arXiv:2512.22414.
Mischt 3 bis 5 Stunden egozentrisches menschliches Video pro Aufgabe je zur Hälfte mit Roboterdaten in das Training von π0.5. Die Leistung in Umgebungen, die nur in den menschlichen Daten vorkamen, kann sich nahezu verdoppeln, der Gewinn zeigt sich aber erst nach ausreichend vielfältigem Roboter-Vortraining.